從文案到 YouTube,自動產製解說影片。
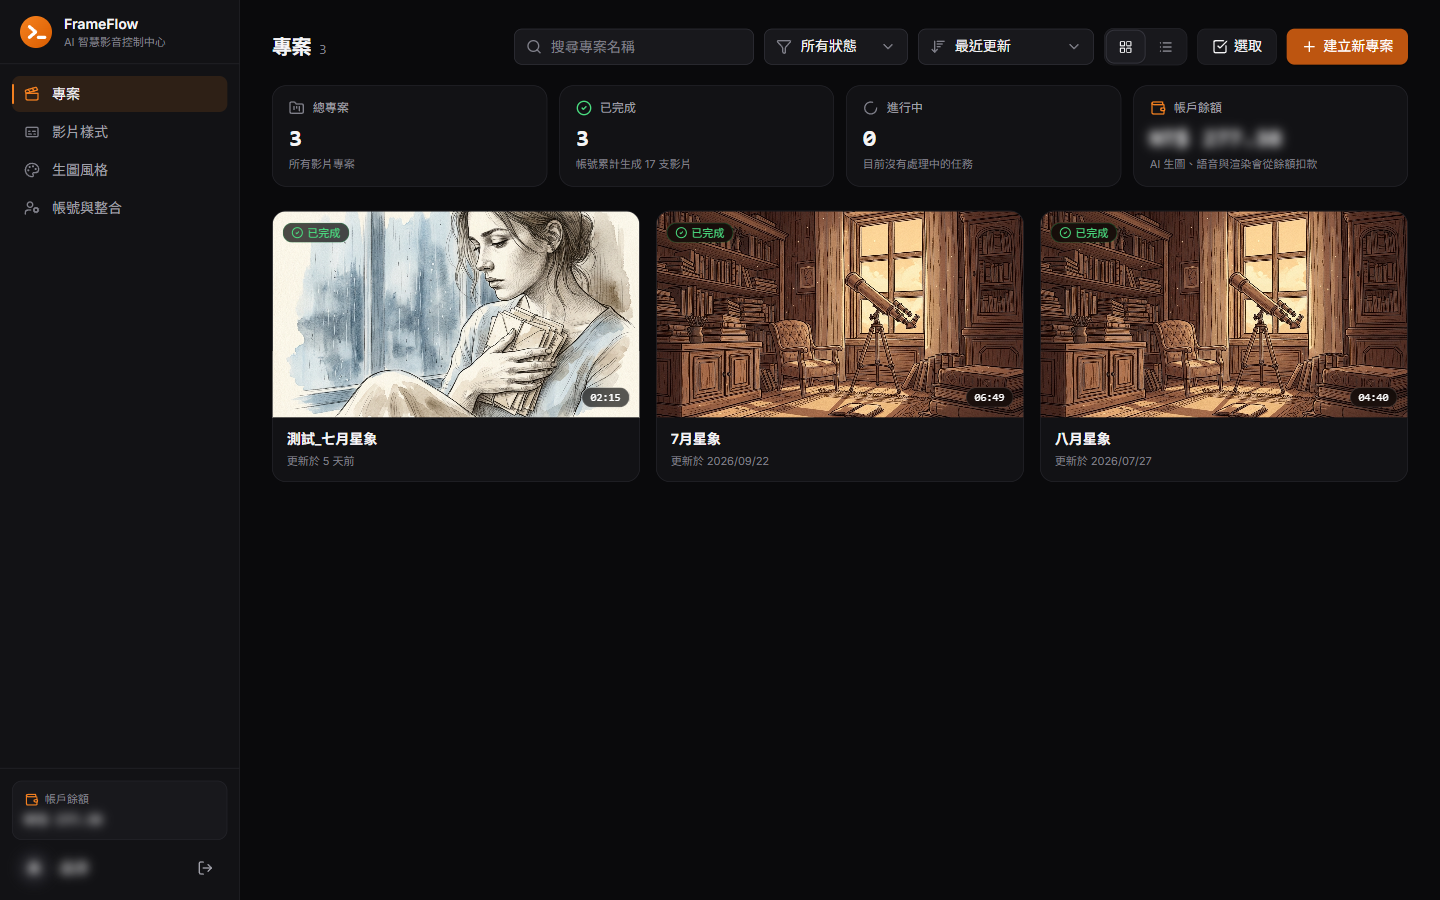
為一間工作室開發的內部系統。文案依序經過 AI 分鏡、風格一致的配圖、圖轉短片(選用)、ElevenLabs 配音與時間軸微調,由 FFmpeg 渲染後上傳 YouTube 並備份至 Google Drive;所有 AI 呼叫皆經由 fluxRelay 計費。
- 種運鏡,另可自動選擇
- 13
- 種運鏡,另可自動選擇
- 影音總誤差,且不累積
- 33 ms
- 影音總誤差,且不累積
- 改用串流複製後的渲染時間
- 36.8→11.7 s
- 改用串流複製後的渲染時間
- 個 API 端點
- 59
- 個 API 端點
01
要解決的問題
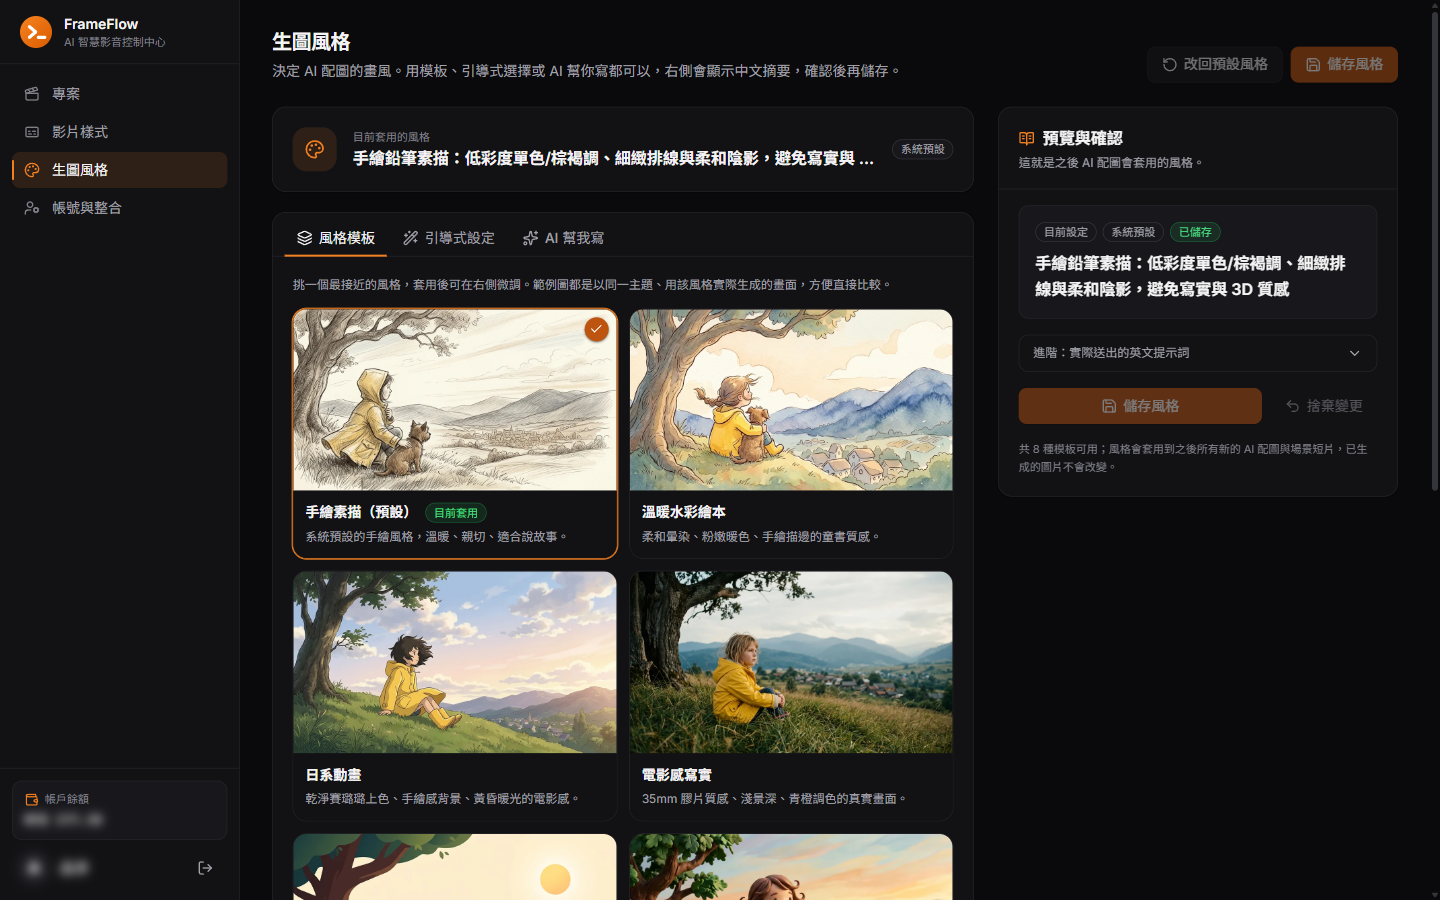
配圖風格不一致
逐張生成的圖片,同一支影片中的角色與筆觸往往難以統一。
影音不同步
場景一多,各段的細微誤差逐漸累積,後段的畫面與語音明顯脫節。
長任務逾時造成損失
曾因一次 120 秒逾時,上游已扣款但結果遺失,因此改為非同步任務搭配輪詢。
局部修改需整段重配
旁白是整段一次生成,只修改一個場景也必須全部重新生成。
02
系統架構
瀏覽器只與 Next.js 溝通,由 Next.js 以同源方式轉發至單一 worker 的 FastAPI。生成工作以背景任務執行,每個專案同時只允許一項會修改資料的工作;AI 供應商的金鑰與計費統一由 fluxRelay 管理。
← 左右滑動看完整流程 →
使用技術
- 前端
- Next.jsReactTailwind CSSwavesurfer.js
- 後端
- PythonFastAPISQLAlchemyPostgreSQL
- AI 與媒體
- GeminiElevenLabsFFmpeg
- 整合與部署
- YouTubeGoogle DriveDockerZeabur
03
主要功能
AI 分鏡
Gemini 將長文切分為場景,並標註語氣、運鏡與生圖描述;也可用空行手動分段。
畫風一致的配圖
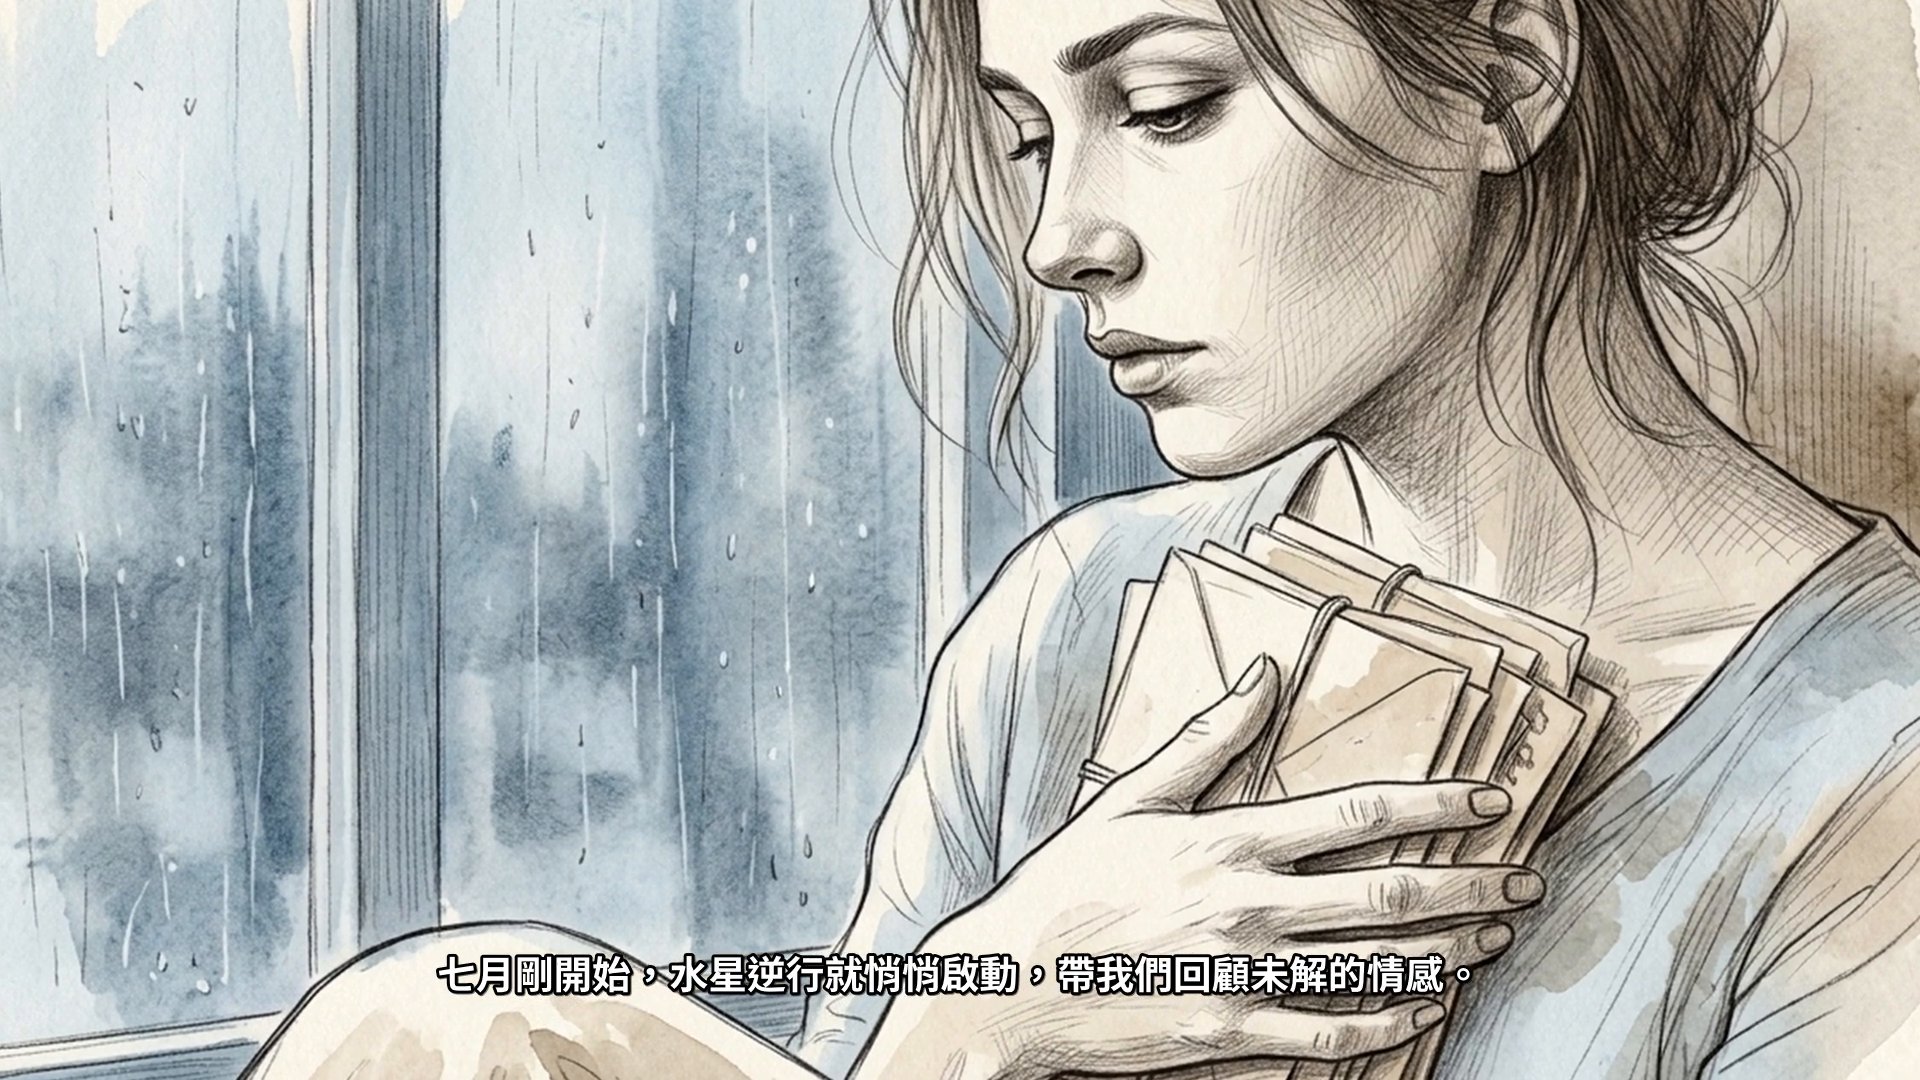
8 種風格模板、參考圖與 AI 輔助撰寫風格,支援重新生成與局部修改。
圖轉短片(選用)
省錢模式固定 4 秒,或依場景長度選擇 4、6、8 秒。
配音
ElevenLabs 可調整聲音與穩定度,提供 27 種語氣標籤;也可逐場景人工錄音。
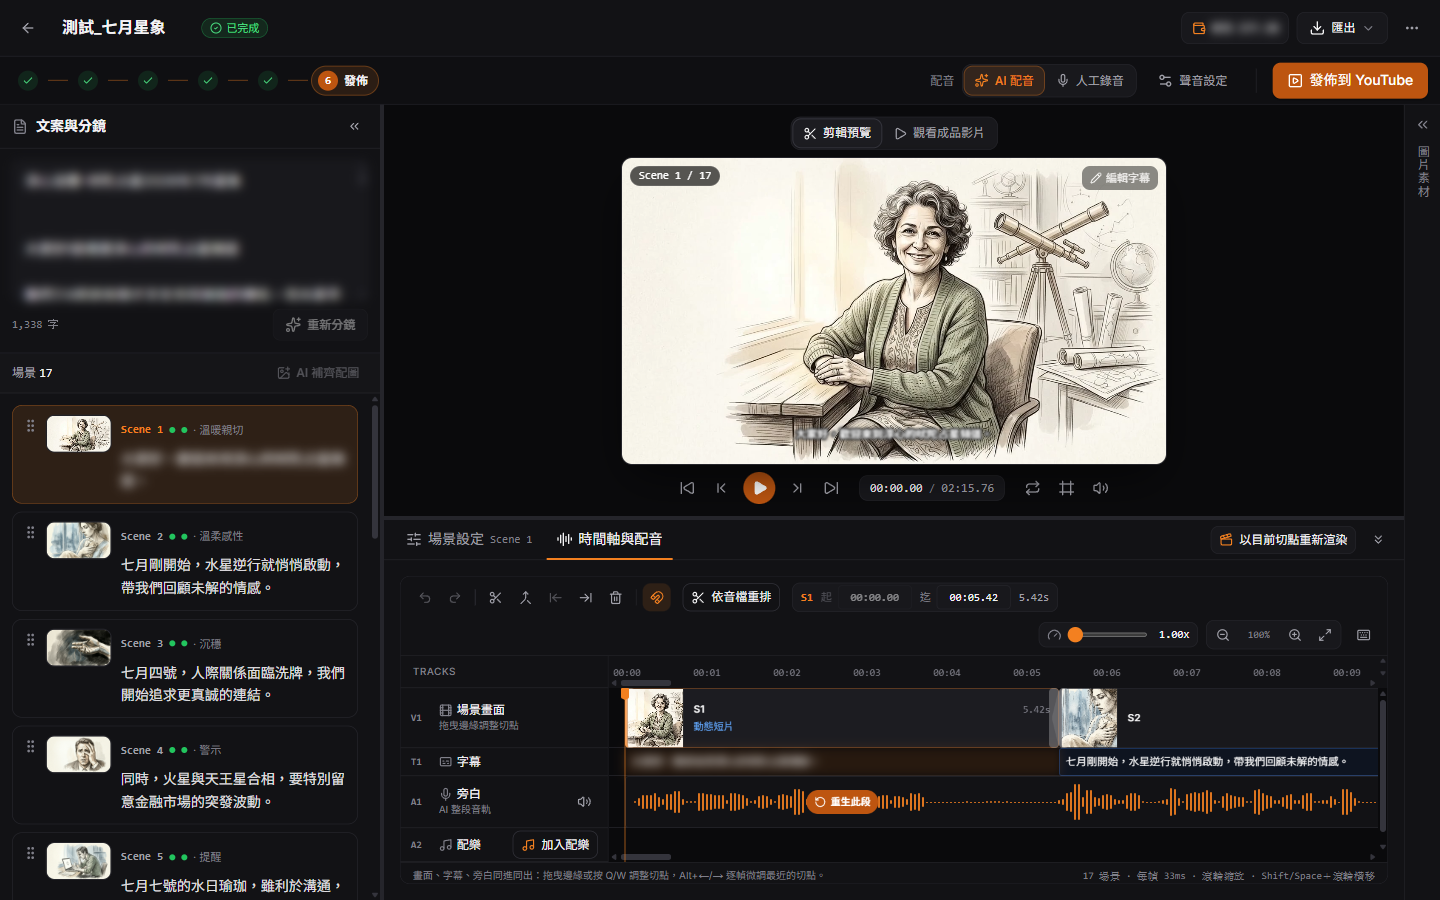
波形時間軸
邊聽邊依音檔重排場景,並可單獨重新配音。
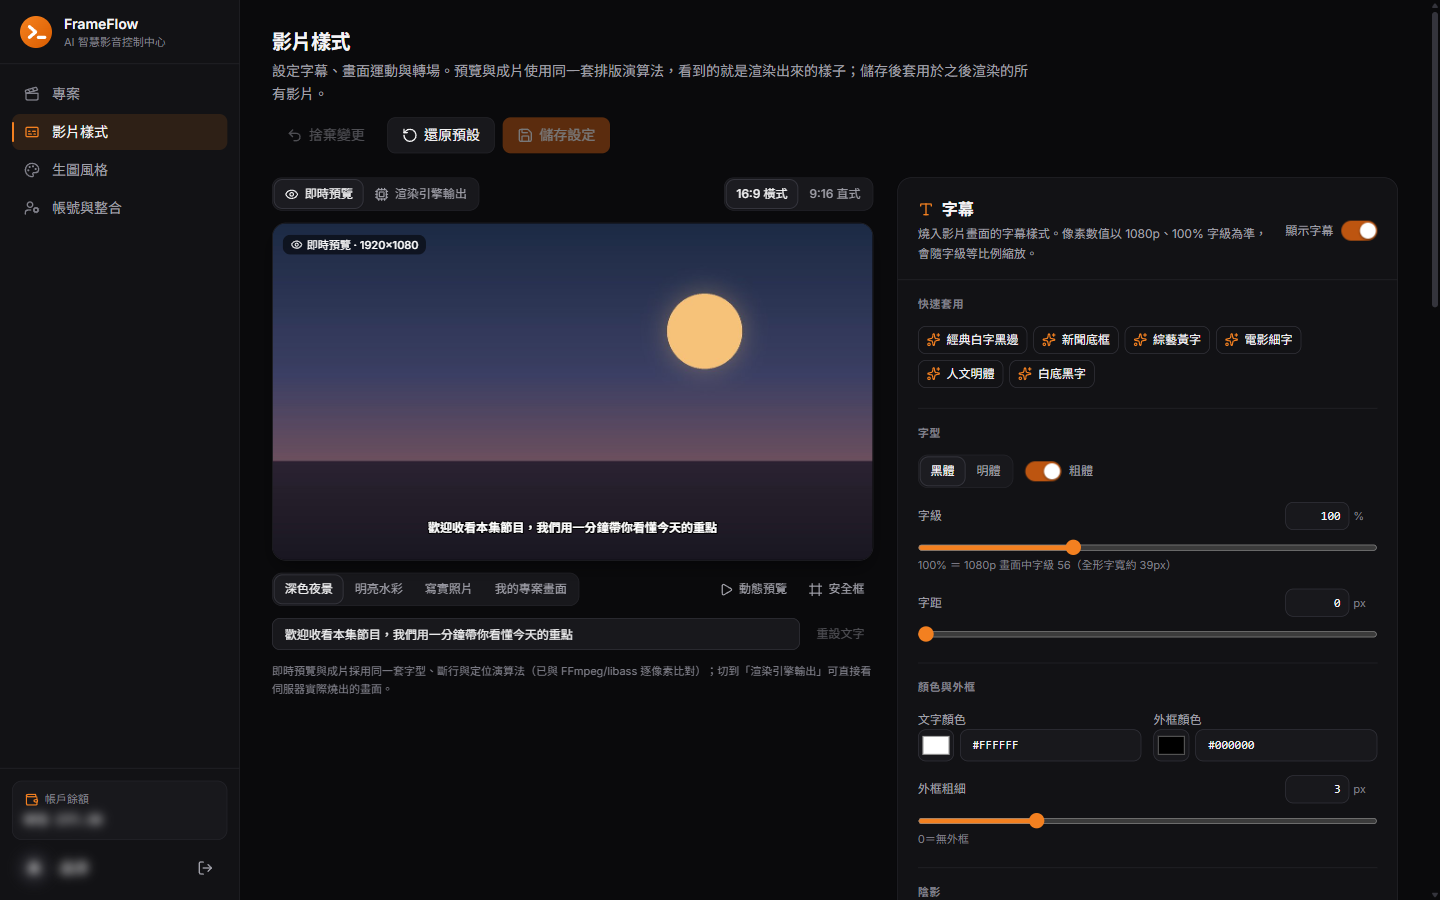
運鏡與字幕
13 種運鏡、字幕樣式、片頭片尾、背景音樂與 1.0–2.0× 播放速度。
一鍵成片
從分鏡到成片一次完成,成功或失敗皆以 Email 與 Discord 通知。
發佈
上傳 YouTube(由 AI 擬定標題與說明),並備份至 Google Drive。
04
技術細節
04.1
影格對齊:場景長度貼齊 30 fps 格線
旁白整段只生成一次,再以逐字時間戳切分場景;場景邊界取下一個場景的起點,長度對齊影格格線,每段以精確影格數輸出。
- 停頓不會造成漂移,最後一個場景延伸至音檔結尾。
- 依提交紀錄,總誤差為 33 ms,且不會累積。
整段旁白(逐字時間戳)
影格格線(30 fps,0–1 秒)
場景 1場景 2① 邊界 = 下一場景開始:472 ms
② 貼齊第 14 格:466.7 ms
③ 用 -frames:v 14 輸出
數值為說明用的例子。
04.2
風格錨點:以第一張圖統一畫風
專案尚無圖片時,第 1 個場景只依使用者的參考圖單獨生成,並作為錨點;其餘場景再同時參考「參考圖+錨點」平行生成。
- 每張圖的提示詞分為四層:場景描述、風格、構圖(單一主體)與負面指令。
- 正在重新生成的圖片不會被選為錨點。
使用者參考圖
① 場景 1 單獨生成
② 其餘場景帶著「參考圖+錨點」平行生成
每張圖的提示詞
1場景描述2風格指令3構圖:只有一個主體4負面指令色塊只是示意,不是系統實際產出的圖。
04.3
單一場景重新配音
新的配音片段以 FFmpeg 接回原音檔,前後各保留 0.8 秒;之後的場景與字幕時間一併平移。
整段旁白音軌
場景 1場景 2場景 3場景 4場景 5① 只重新生成場景 3
② 前後各補 0.8 秒,用 FFmpeg 接回
③ 後面場景與字幕平移 Δ
05
系統畫面